 Commity.cz sdílí příspěvek kolegy

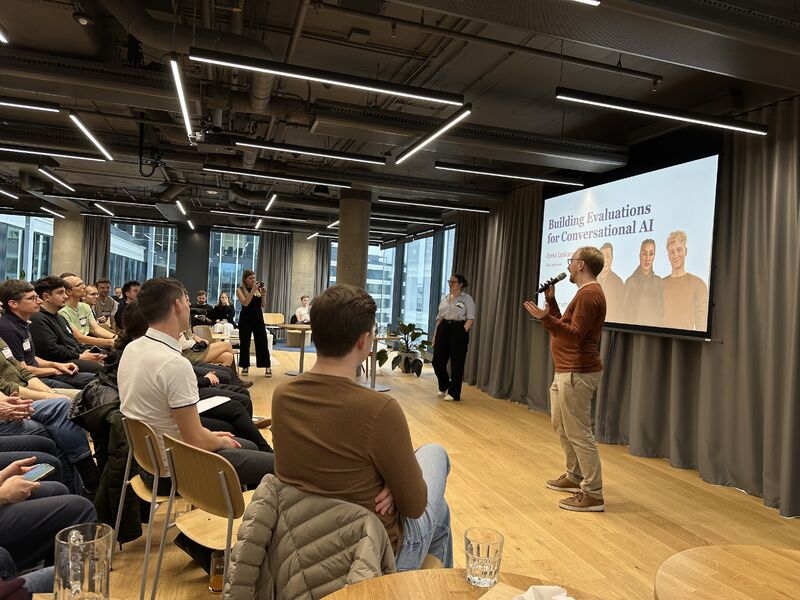
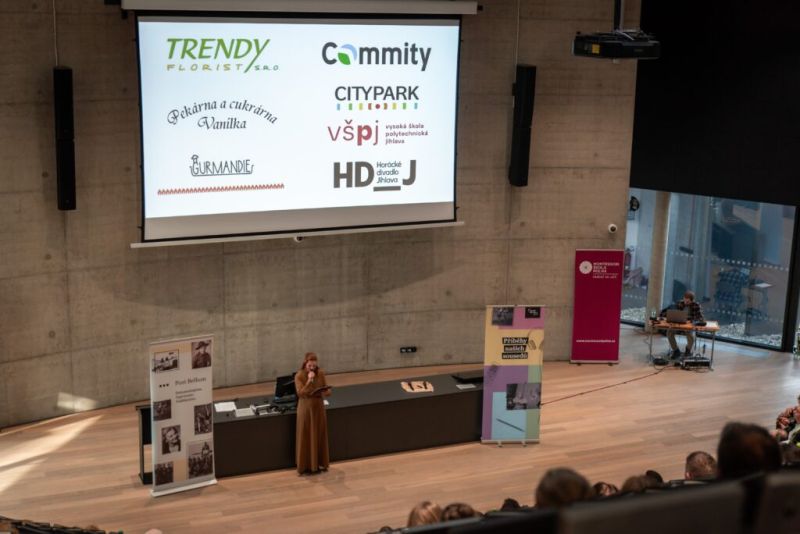
Druhý evals.cz meetup na téma „Evaluace RAGů" v prostorách Shoptet v Portu 7. Tři speakeři, nabitý program, minimum teorie — hlavně zkušenosti z praxe.
S RAGy si v rámci Commity.cz hrajeme už nějakou dobu a co si budem. Evaluace je běh na dlouhou trať s řadou nečekaných překážek. V okamžicích, kdy se všechno jeví nadějně, je třeba nejvíce zbystřit.
Takže pár poznatků, které pro mě rezonovaly nejvíc:
🔹 Matouš Eibich (Waypoint AI) — Jak vyvíjet a evaluovat RAG
• Evals jsou interní produkt, ne technický problém. Pokud eval systém přidává frikci do workflow, de facto neexistuje.
• U LLM-as-a-judge netlačte na maximální přesnost. False positives odhalíte snadno, false negatives vás budou trápit dlouho.
• Denní Slack report z produkce > komplexní benchmarky. Benchmarky dávají smysl u stabilních projektů; u dynamicky se vyvíjejícího produktu zastarávají rychleji, než je stíháte měnit.
🔹 Aneta Leskourová (PromethistAI) — Benchmark pro multi-turn konverzační AI
• Standardní benchmarky pokrývají „working with computers", ale téměř ne „interacting with others".
• Funkční architektura: simulovaný uživatel ↔ testovaný agent → LLM judge hodnotí transcript. Klíč je v realističnosti simulovaného uživatele — jinak testujete agenta proti fikci.
• Simulovaní uživatelé potřebují databázi, ne prompt. Proměnné (věk, styl, cíl) → semi-random kombinace → backstory. Bez toho dostanete generické persony.
• U konverzačního AI neexistuje ground truth. Benchmark sám musí projít validací, jinak měříte šum s vysokou přesností.
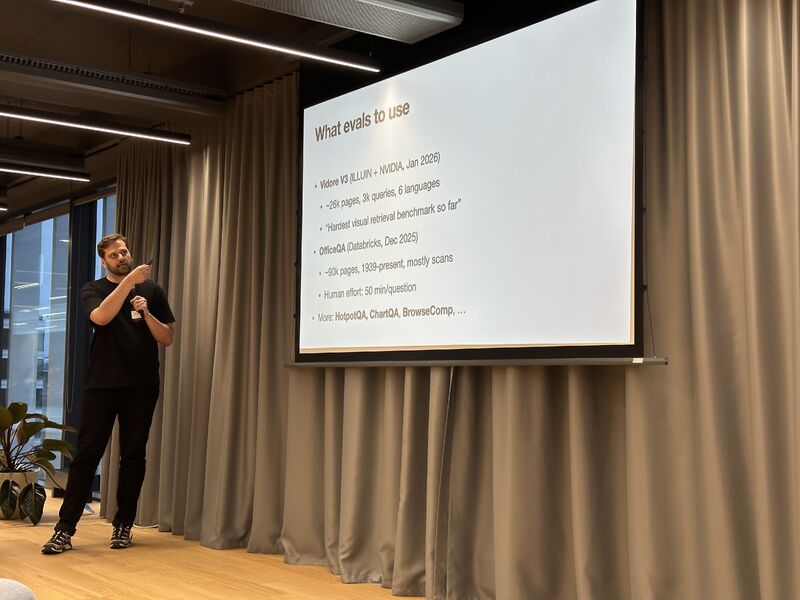
🔹 Jerguš Lejko (TopK.io) — Vyhodnocování a zlepšování RAG retrievalu
• Největší zisk je v parsingu a získávání dat. Změna LLM nebo embeddingů hýbe metrikami překvapivě málo.
• Pre-filtering > post-filtering. Hybridní search (sémantický + BM25) v jedné DB je nutnost, ne nice-to-have.
• Strukturální chunking (headings, odstavce) je solidní baseline. Contextual chunking přes LLM často nafoukne tokeny bez odpovídajícího zlepšení.
• Query agenti: plan first, then execute. Explicitní stavy místo volných smyček — zabrání infinite loops a produkují observovatelné traces.
• V judge promptu dejte reasoning před verdikt. Pořadí měřitelně ovlivňuje spolehlivost hodnocení.
Nejsilnější společný motiv napříč přednáškami: evaluace není měření, je to produkt. A jako každý produkt potřebuje adopci, nikoli jen přesnost.
Velký dík organizátorům Šimon Podhajský a Veronika Pe za parádně připravenou akci.
Už podruhé mám hlavu plnou myšlenek, co zlepšit 😀. A jak máte evals nastavené vy — žijí si samostatně nebo už jsou součástí každodenního vývoje?